Critique du livre : If Anyone Builds It, Everyone Dies
Scott examine un nouveau livre de Yudkowsky et Soares qui plaide sans compromis pour l’arrêt du développement de l’IA afin d’éviter l’extinction de l’humanité. Il en analyse les arguments et la portée possible en tant qu’appel à l’action.
I.
Le Machine Intelligence Research Institute d’Eliezer Yudkowsky est la toute première organisation de sûreté de l’IA. Mais être le premier n’est pas toujours un avantage : comment va la Mésopotamie, ces temps-ci ? Alors que l’argent, les cerveaux et le prestige affluent dans le domaine, MIRI reste ce qu’il a toujours été : un groupe de gens bizarres assez peu organisés, dont l’un refuse obstinément de cesser de porter un haut-de-forme à paillettes en public. Alors, quand je distribuais des subventions dans le domaine de l’IA l’an dernier, je leur ai demandé : pourquoi vous financer, vous, plutôt que ceux qui ont une armée de jeunes diplômés de Harvard pleins d’enthousiasme, ou ceux qui viennent de s’offrir Geoffrey Hinton comme porte-parole vedette ? Qu’avez-vous qu’ils n’ont pas ?
MIRI m’a répondu : la clarté morale.
La plupart des gens qui travaillent dans la sûreté de l’IA (moi compris) sont dans l’incertitude, ne savent pas trop quoi penser et cherchent les solutions progressives les moins mauvaises. Nous pensons que l’IA sera probablement une technologie passionnante qui transformera le monde, mais qu’il y a une certaine probabilité, 5, 15 ou 30 %, qu’elle se retourne contre l’humanité de façon catastrophique. Ou, si ce n’est pas le cas, qu’il arrive quelque chose de moins catastrophique mais tout de même mauvais : peut-être que l’humanité passera peu à peu à l’arrière-plan, comme les rois et les nobles l’ont fait à l’époque moderne. C’est effrayant, mais l’IA arrive, qu’on le veuille ou non, et trop chercher à la retarder comporte probablement aussi des risques. Nous ne savons pas exactement quoi faire, mais pour l’instant, nous voulons poser des bases solides pour réagir à toute menace future. Cela veut dire veiller à ce que les entreprises d’IA soient honnêtes et transparentes, aider des entreprises responsables comme Anthropic à rester dans la course et investir dans la compréhension de la structure des objectifs des IA et de la manière dont elles interprètent nos instructions. Puis, à un moment donné, nous serons assez proches de l’IA vraiment dangereuse pour mieux comprendre la nature de la menace, obtenir une plus large adhésion du public et décider de la suite.
MIRI trouve ça pathétique : autant essayer de se protéger de la chute d’un astéroïde en portant un casque de chantier. Ils restent assez évasifs sur la probabilité qu’ils attribuent eux-mêmes à l’extinction de l’humanité par l’IA, mais elle semble se situer autour de 95-99 %. Ils estiment que les progrès réalisables en matière de responsabilité des entreprises, de qualité de la réglementation et de recherche universitaire sur l’IA sont inférieurs de plusieurs ordres de grandeur à ce qu’il faudrait pour s’attaquer sérieusement au problème. Et ils ne s’attendent pas à un « coup de semonce » qui leur permettrait de remettre sereinement le problème à plus tard, jusqu’à ce que tout s’éclaircisse et qu’il soit facile d’agir. Ils proposent d’interdire immédiatement toute recherche visant à accroître les capacités des IA, et de ne la reprendre que dans un avenir lointain, quand la situation paraîtra plus favorable.
Les deux camps croient sincèrement à leur position et ne veulent pas adapter leur discours pour des raisons de communication. Mais chacun pense aussi, comme par hasard, que son discours passe mieux auprès du public. Les partisans d’une approche progressive estiment qu’une démarche modérée et prudente permet de garder le dialogue ouvert avec le monde universitaire, l’industrie, les pouvoirs publics et d’autres acteurs qui préfèrent avoir affaire à des interlocuteurs normaux, bien rasés et qui ne postillonnent pas chaque fois qu’ils ouvrent la bouche. MIRI pense que le public en a assez des conneries tièdes testées auprès de groupes de discussion, mais qu’il pourrait être prêt à se soulever contre l’IA si quelqu’un lui exposait les arguments clairement et sans hésitation.
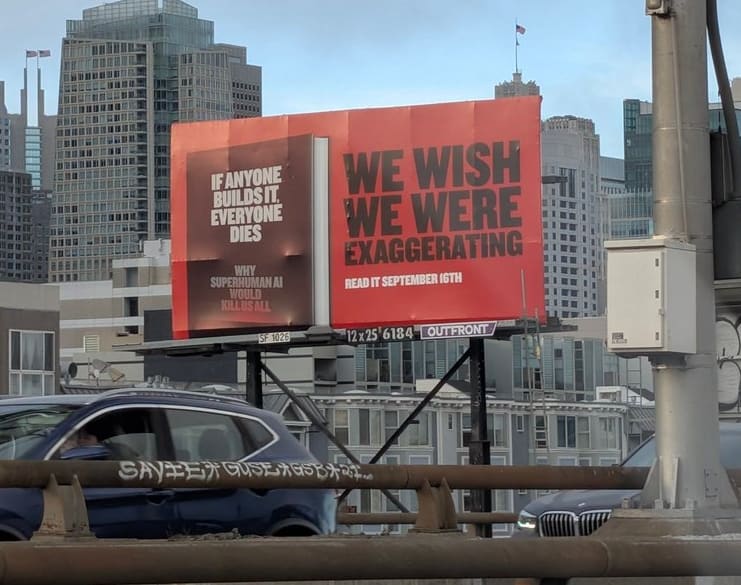
Yudkowsky et son coauteur, Nate Soares, président de MIRI, ont atteint de nouveaux sommets en matière d’absence de toute ambivalence avec leur prochain livre, If Anyone Builds It, Everyone Dies (sortie le 16 septembre, déjà disponible en précommande).
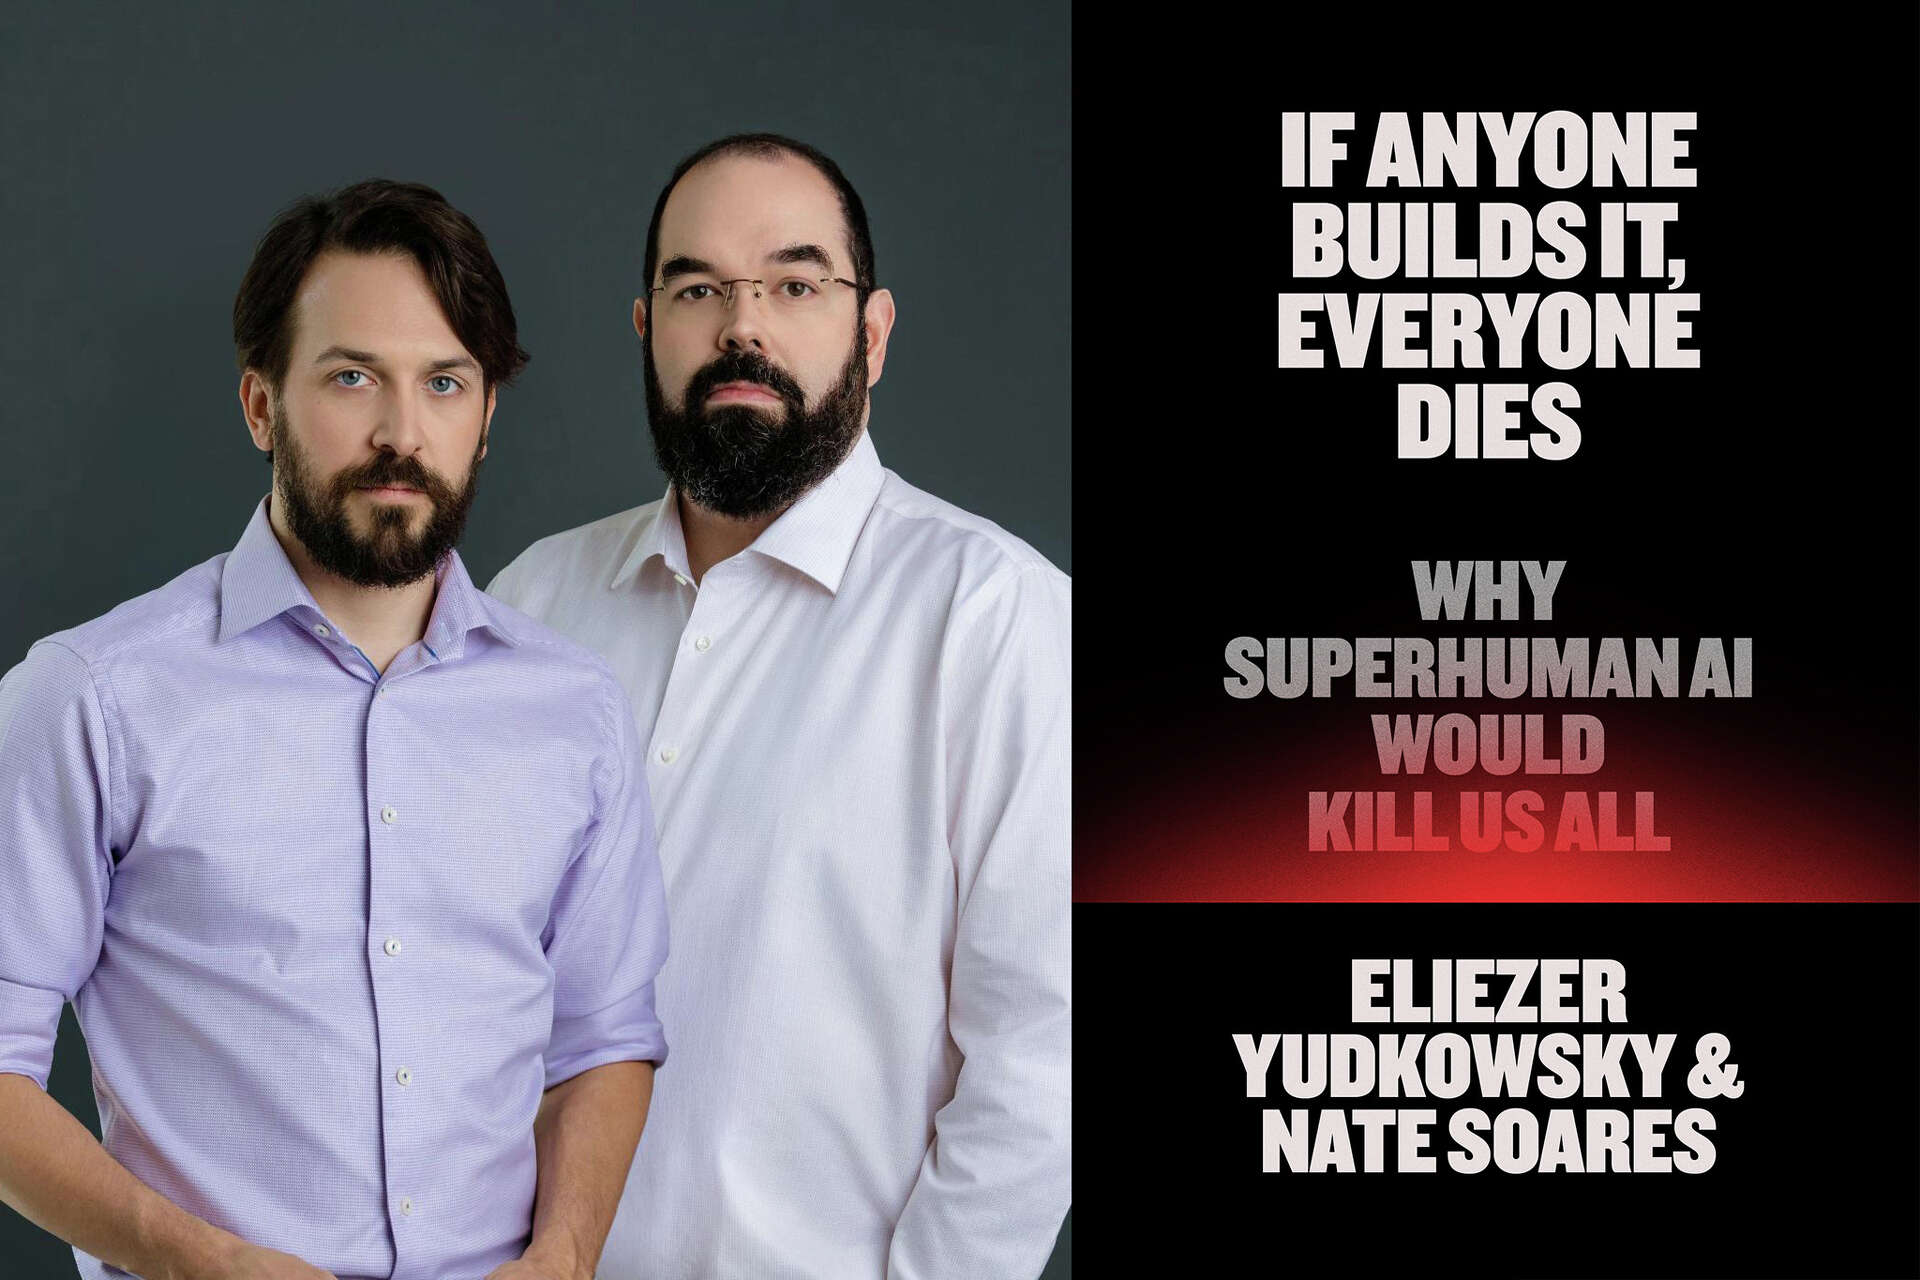
IABIED comporte trois parties. La première expose les raisons fondamentales pour lesquelles l’IA est dangereuse. La deuxième raconte une histoire de science-fiction bien précise montrant comment la catastrophe pourrait se produire, en précisant comme il se doit qu’il ne s’agit que d’un exemple et que personne ne peut savoir avec certitude ce qui se passera. La troisième examine ce qu’il faut faire à partir de là.
II.
Le monde a-t-il vraiment besoin d’un énième article intitulé « Pourquoi l’IA pourrait être dangereuse » ?
D’un côté, oui, sans aucun doute. Si vous êtes un « infovore », vous n’imaginez pas à quel point le grand public manque d’informations (saviez-vous que 66 % des Américains n’ont jamais utilisé ChatGPT, et que 20 % des Américains n’en ont même jamais entendu parler ?). La grande majorité des gens ne savent probablement rien de tout ça.
Même ceux qui pensent connaître les arguments n’en ont probablement entendu que quelques bribes, à droite et à gauche, de la même façon que « tout le monde connaît » l’Odyssée, alors que seule une petite fraction des gens en a lu ne serait-ce qu’une ligne. Alors oui, présenter les principaux arguments sur plusieurs chapitres à des dizaines de milliers de personnes a certainement de la valeur. Même parmi vous, lecteurs, beaucoup sont sans doute dans ce cas, et si j’étais quelqu’un de meilleur, je passerais tout cela en revue ici, en détail.
Malgré tout, je n’arrive pas à m’y résoudre : ça me paraît ennuyeux et inutile. Pourquoi ?
Les raisons fondamentales de craindre l’IA sont simples. Nous ne savons pas encore vraiment comment lui donner des objectifs précis ; jusqu’ici, nous nous sommes plus ou moins contentés de lui ajouter au fur et à mesure une tendance superficielle à obéir, en partant du principe qu’elle est trop bête pour que les erreurs aient vraiment de l’importance. Mais l’IA devient rapidement plus intelligente. À un moment donné, elle sera peut-être plus intelligente que les humains. Puisque notre avantage intellectuel nous a permis de prendre la place des chimpanzés et d’autres animaux moins intelligents, peut-être que l’IA finira par prendre la nôtre.
Il y a une réponse raisonnable à cet argument. Elle consiste à objecter qu’il enchaîne beaucoup d’hypothèses, dont chacune risque de ne pas se vérifier, ou du moins de mettre très longtemps à se réaliser. S’il y a X % de chances qu’il faille N années pour obtenir une IA plus intelligente que les humains, Y % de chances qu’il faille P années pour qu’une IA intelligente se diffuse dans toute l’économie, et Z % de chances qu’il faille Q années avant que l’IA surmonte l’avantage que les humains tirent de leur position établie et devienne plus puissante que nous, alors on peut peut-être estimer qu’il y a de fortes chances que le danger ne se présente que dans plus d’un siècle. Et dans un siècle, nous disposerons peut-être de meilleures techniques d’alignement, ou au moins d’une vision plus claire du problème. Pourquoi s’inquiéter de choses vagues qui pourraient se produire ou non dans un siècle ?
Le problème, c’est qu’il est difficile de faire jouer les probabilités sans qu’il reste au moins 5 à 10 % de chances que le scénario cauchemar se produise au cours des dix prochaines années. Il faudrait être un étrange mélange : très bon en probabilités (pour savoir ajouter assez d’épicycles afin de désamorcer l’argument) et très mauvais en probabilités (pour avoir envie de le faire).
Il n’y a pas tant de gens qui présentent ce dosage précis de compétence et d’incompétence en probabilités. Alors tous les autres se rabattent sur une épistémologie complètement lunaire.
Certains citent l’exemple d’une prédiction passée qui ne s’est pas réalisée, comme si cela prouvait que toutes les prédictions doivent toujours échouer, puis tombent des nues et ne savent plus quoi penser si vous leur rappelez que d’autres prédictions passées se sont réalisées.
Certains disent : « Tel résultat mathématique compliqué que je connais montre qu’une véritable intelligence est impossible », puis n’ont aucune explication à donner quand on leur demande pourquoi ce résultat mathématique compliqué n’exclut pas l’existence des humains.
Certains disent : « Vous n’avez pas le droit d’avancer qu’une catastrophe pourrait anéantir l’espèce humaine, parce que ça ne s’est jamais produit et que rien ne peut jamais se produire pour la première fois. » Puis ces mêmes personnes paniquent à propos du réchauffement climatique, de la baisse de la fécondité ou de je ne sais quoi d’autre.
Certains disent : « Le vrai danger, ce n’est pas l’IA superintelligente, c’est X ! » alors que le danger pourrait très bien venir à la fois de l’IA superintelligente et de X. X peut désigner aussi bien l’IA à court terme que les humains qui utilisent l’IA à mauvais escient, les oligarques de la tech qui s’enrichissent et gagnent en puissance grâce à l’IA, ou encore des choses sans aucun rapport, comme le changement climatique ou le racisme. Grisés par le plaisir de recourir à une ficelle rhétorique facile, ils finissent par se convaincre qu’apporter assez de preuves de la dangerosité de X les dispense de démontrer que l’IA superintelligente ne l’est pas.
Certains disent : « Vous n’avez pas le droit d’avancer que quelque chose de grave pourrait se produire sans avoir un modèle mathématique précis qui indique exactement quand et pourquoi. » Puis ces mêmes personnes disent s’inquiéter de voir l’IA renforcer les biais, saper la confiance entre les gens ou faire autre chose sans qu’elles aient de modèle mathématique précis pour ça.
Il n’existe que quelques bons arguments contre une thèse donnée. Mais il existe une infinité d’arguments complètement lunaires. « Calvin Coolidge était le pape, donc votre position ne tient pas » : comment se prémunir à l’avance contre ça ? Impossible. Comme on ne peut jamais prévoir quel argument complètement lunaire quelqu’un va sortir, et que dresser la liste de tous les arguments complètement lunaires possibles pour les réfuter donne soi-même l’air complètement lunaire, on finit plus ou moins par laisser tomber — ou, dans le cas d’Eliezer, par faire une pause de plusieurs années pour enseigner aux gens les rudiments de l’épistémologie.
Pourquoi ces discussions se passent-elles si mal ? Je suis généralement contre l’idée de psychanalyser mes contradicteurs, mais je vais demander pardon aux saints rationalistes et avancer une théorie.
Je pense que c’est parce que, si c’est vrai, ça change tout. Mais ce n’est pas manifestement vrai, et ce serait gênant que ça change tout. Donc ça ne doit pas être vrai.
Et comme la plupart des gens refusent d’employer cette formulation concise et élégante, ils cherchent, dans l’espace des raisonnements, ce qui se rapproche le plus de cette justification, et finissent par dire des choses comme : « Eh bien, vous devez prouver mathématiquement toutes vos affirmations. »
Pour ne pas donner l’impression de balayer tout ça d’un revers de main, je me rends compte que je raisonne moi-même ainsi tout le temps. Les exemples qui me viennent le plus facilement à l’esprit, là, tout de suite :
- Certains affirment que le nombre de spermatozoïdes chez l’homme diminue et que, d’ici une vingtaine d’années, il sera si bas qu’on ne pourra plus concevoir d’enfants naturellement. Si c’était vrai, ça changerait tout, et nous devrions laisser tomber ce que nous faisons pour nous en occuper dès maintenant (plus de détails ici). Mais ce serait gênant. Alors nous partons du principe que c’est probablement faux, ou du moins que nous pourrons nous en occuper plus tard.
- Certains affirment qu’en plus des effets néfastes habituels du réchauffement climatique, le changement climatique va, pour une raison ou une autre, devenir bien pire très bientôt. Un courant océanique important s’arrêtera, un gisement de méthane se libérera tout seul, un phénomène s’emballera, ou la fonte des glaces libérera d’horribles maladies (j’examine les arguments pour et contre cette dernière possibilité ici). Si c’était vrai, ça changerait tout, et nous devrions remplacer notre lente décarbonation actuelle par un plan d’action d’urgence, sous une forme ou une autre. Mais ce serait gênant.
- Certains affirment que la fécondité s’effondre et que, dans quelques décennies, il ne restera plus assez de jeunes pour subvenir aux besoins de toutes les personnes âgées, tandis que, dans quelques siècles, l’existence même de la civilisation humaine sera menacée. Si c’était vrai, ça changerait tout, et nous devrions prendre des mesures soit extrêmement socialistes, soit extrêmement réactionnaires (selon leurs convictions politiques). Mais ce serait peut-être gênant (selon les vôtres).
- Certains affirment que les abeilles disparaissent et que, faute de pollinisation des plantes, l’agriculture s’effondrera. D’autres disent qu’en fait, tous les insectes disparaissent, et que la chaîne alimentaire s’effondrera alors, déstabilisant la biosphère. Pour l’instant, la situation des abeilles semble stable ; pour les autres insectes, c’est toujours une question ouverte. Mais c’est une question ouverte qui nous obligerait à avoir une opinion bien arrêtée sur les méthodes de comptage des insectes, faute de quoi nous risquerions une déstabilisation de la biosphère, et ce serait gênant.
- Certains affirment qu’une idéologie politique qu’ils rejettent (le wokisme, l’immigration de masse, MAGA, la progression insidieuse du socialisme, le techno-féodalisme, etc.) est sur le point de détruire à jamais les fondements de la société libérale, que les stratégies habituelles de mobilisation électorale ne suffisent pas et qu’il faudrait peut-être tenter des solutions désespérées, comme instaurer un gouvernement antilibéral ou se soulever par les armes. Si c’était vrai, ça changerait tout. Mais il n’est pas évident que ce soit vrai, et mettre fin à notre époque actuelle de paix, de prospérité et de démocratie serait gênant.
Chacun de ces scénarios fait l’objet de nombreux travaux qui présentent les arguments pour et contre. Mais ceux d’entre nous qui ne sont pas spécialistes du sujet doivent décider eux-mêmes s’il faut paniquer et exiger que tout change d’un coup. Il est peu probable que nous lisions l’intégralité du débat et en ressortions avec la conviction solide et bien fondée que le risque n’est certainement pas réel. Alors, que faire ? Plus précisément, que faire si ceux qui annoncent chacune de ces catastrophes disent qu’il est très difficile d’être certain à plus de 90 % qu’ils se trompent, et que même un risque de 5 à 10 % pour l’une d’elles pourrait justifier de paniquer et de tout changer ?
En pratique, nous haussons plus ou moins les épaules en disant que ces risques ne sont pas suffisamment établis pour nous faire paniquer et tout changer, que nous allons attendre en restant vigilants et que nous changerons peut-être d’avis si des preuves plus solides apparaissent plus tard. Si quelqu’un exige que nous justifiions cette étrange position, les gens avertis construiront des modèles probabilistes élaborés (ou invoqueront le point de vue extérieur auquel je fais appel ici), tandis que les autres chercheront à tâtons une explication à leur indifférence et se rabattront sur des arguments complètement lunaires du genre « on n’a jamais le droit de dire que quelque chose va anéantir l’humanité » ou « on ne peut rien affirmer sans preuve mathématique ».
On peut dire deux choses en faveur de cette stratégie :
Premièrement, sans elle, nous aurions tout changé des dizaines de fois pour éviter des catastrophes qui ne se sont absolument pas produites. L’exemple le plus clair est celui de la surpopulation, pour laquelle nous avons bel et bien stérilisé de force des millions de personnes — mais face à laquelle une réponse mondiale vraiment sérieuse aurait été pire de plusieurs ordres de grandeur.
Deuxièmement, il lui est parfois arrivé de nous laisser avancer les yeux fermés vers la catastrophe, pendant que les experts nous assuraient jusqu’au bout que tout allait bien parce que [arguments complètement lunaires]. L’exemple le plus clair est la période où le Covid était encore cantonné à la Chine : il était évident que ce virus extrêmement contagieux, qui avait échappé à toutes les mesures d’endiguement plausibles, déclencherait une pandémie mondiale, mais les médias n’ont cessé de nous rassurer en disant que c’était « spéculatif », qu’il n’y avait « aucune preuve », ou que s’en inquiéter risquait de détourner l’attention de vrais problèmes à court terme qui se posaient dès maintenant, comme le racisme antichinois. Puis, quand le Covid a atteint les États-Unis, nous avons été pris au dépourvu et avons paniqué.
Alors, peut-être qu’un argument convaincant ici consisterait moins à répéter pourquoi l’IA progresse ou pourquoi l’alignement est difficile, qu’à expliquer pourquoi il ne faut pas appliquer une règle générale de méfiance envers les risques hypothétiques dans ce cas précis. On pourrait soit soutenir que cette règle est mauvaise en soi, soit dire qu’elle est généralement valable, mais qu’elle devrait se limiter à l’effondrement de la fécondité et à la disparition des abeilles, sans s’appliquer ici.
Je ne pense pas qu’il existe une réponse définitive à cette question en une seule phrase. Ces problèmes exigent du bon sens pratique : la même qualité qui vous dit qu’il ne faut pas appeler le 9-1-1 à chaque légère douleur à un orteil, mais que vous devez appeler le 9-1-1 si du sang se met soudain à couler à flots de vos yeux. Les gens qui ont du bon sens pratique gardent un œil sur les problèmes douteux sans s’en préoccuper, réagissent avec détermination aux problèmes importants et, en cas de doute, préfèrent pécher par excès de prudence. En puisant dans les réserves limitées de bon sens pratique dont je dispose, je dirais que nous n’investissons pas assez dans la prévention des catastrophes apocalyptiques en général (le problème de la réponse à la surpopulation, c’est qu’elle était violente et antilibérale, pas que nous ayons essayé de nous préparer à un danger qui semblait réel), mais aussi qu’il y a davantage de raisons de s’inquiéter de l’IA que de la baisse du nombre de spermatozoïdes, par exemple. Je pense aussi que la nature du problème (nous faisons apparaître une superintelligence qui peut nous surpasser sans effort) fait qu’il est particulièrement important de le prévenir plutôt que de réagir après coup.
Mais la critique vaut aussi pour moi. Alors, quand j’imagine un sceptique essayer de me psychanalyser, il dirait : Scott, tu as découvert l’IA quand tu avais une vingtaine d’années. À cet âge-là, tout le monde a besoin d’une croisade pour sauver le monde. En choisissant l’IA, tu as échappé au catastrophisme climatique ou à une forme aiguë de wokisme, ce qui a sans doute été une chance. Mais maintenant, tu as vieilli, tu as déjà une croisade dans la case réservée aux croisades, et en lancer une deuxième serait gênant. Alors, quand tu entends dire que la baisse du nombre de spermatozoïdes va tous nous tuer, tu te renseignes assez superficiellement, puis tu décrètes que ça ne vaut pas la peine de s’inquiéter. C’est très bien, et ça permet de garder la tête sur les épaules ; mais aie une pensée pour les gens qui n’ont plus la vingtaine non plus et qui font pareil avec l’IA.
III.
Si tout cela vous paraît trop peu tranché, je suis d’accord : c’est en partie pour ça que je suis un modéré ennuyeux, avec une p(doom) inférieure à 25 % et de bonnes relations avec les entreprises d’IA. IABIED fait-il mieux ?
Je n’en suis pas sûr. Le livre reprend essentiellement l’argumentation classique telle que je l’ai présentée plus haut, même si, bien sûr, comme Eliezer y a participé, elle est mieux écrite et ponctuée de jolies paraboles :
Imaginez, si vous voulez bien — même si, bien sûr, rien de tout cela n’est jamais arrivé, puisque ce n’est qu’une parabole — que la vie biologique sur Terre soit née d’un jeu entre dieux. Qu’un dieu des tigres ait créé les tigres et qu’un dieu des séquoias ait créé les séquoias. Imaginez qu’il y ait des dieux pour différentes sortes de poissons et de bactéries. Imaginez que ces joueurs rivalisent pour assurer la domination des familles d’espèces qu’ils soutiennent, tandis que les êtres vivants parcourent la planète sous leurs yeux.
Imaginez qu’environ deux millions d’années avant notre époque, un obscur dieu des singes contemple leur immense plateau de jeu, aussi grand qu’une planète.
— Il me faudra encore quelques coups, dit le dieu des hominidés, mais je crois que j’ai la partie dans la poche.
Un silence perplexe s’est installé, tandis que de nombreux dieux examinaient le plateau pour voir ce qui leur avait échappé. Le dieu des scorpions a demandé : « Comment ? Ta famille d’“hominidés” n’a ni armure, ni griffes, ni venin. »
— Leur cerveau, a répondu le dieu des hominidés.
— Je les infecte et ils meurent, a dit le dieu de la variole.
— Pour l’instant, a dit le dieu des hominidés. Ta fin viendra vite, Variole, quand leurs cerveaux auront appris à te combattre.
— Ils n’ont même pas les plus gros cerveaux qui soient ! a dit le dieu des baleines.
— La taille ne fait pas tout, a dit le dieu des hominidés. La structure de leur cerveau joue aussi un rôle. Donne-leur deux millions d’années et ils marcheront sur la lune de leur planète.
— Je ne vois vraiment pas où le métabolisme de cette créature produit du carburant pour fusée, a dit le dieu des séquoias. Il ne suffit pas de réfléchir pour se retrouver en orbite. À un moment donné, il faut que ton espèce évolue pour acquérir un métabolisme capable de purifier du carburant pour fusée — et qu’elle devienne assez grande, idéalement haute et étroite — avec une coque extérieure rigide, pour ne pas gonfler et mourir dans le vide spatial. Ton singe aura beau se creuser la tête tant qu’il voudra, il restera au sol à se creuser la tête. « Certains d’entre nous jouent à ce jeu depuis des milliards d’années », a dit un dieu des bactéries en lançant un regard en coin au dieu des hominidés. « Jusqu’ici, les cerveaux n’ont pas constitué un avantage si décisif. »
— Et pourtant, a dit le dieu des hominidés
Le livre consacre l’essentiel de ses efforts à l’étape où l’IA finit par ne plus être alignée sur les humains (est-ce à cette étape qu’il devrait s’attarder ? Est-ce celle dont la plupart des gens doutent ?) et, là encore — rien d’étonnant quand on connaît Eliezer —, il s’en tire remarquablement bien. La métaphore centrale compare l’entraînement des IA à l’évolution humaine. Même si l’évolution a orienté les humains vers un objectif, « se reproduire et transmettre leurs gènes », elle l’a fait au moyen d’un ensemble de pulsions extraordinairement variées, complexes et contradictoires : désir sexuel, faim, recherche de statut, etc. Ces pulsions ne menaient pas de façon fiable à la reproduction et à la transmission des gènes. Aujourd’hui, les humains aspirent à des choses aussi diverses que découvrir une théorie quantique de la gravitation, atteindre l’éveil bouddhique, devenir actrice à Hollywood, fonder une start-up valant un milliard de dollars ou obtenir leur prochaine dose de fentanyl. On peut plus ou moins raconter comment la sélection en faveur de la reproduction a produit tout cela (les personnes de statut élevé avaient davantage de possibilités de se reproduire, et fonder une start-up valant un milliard de dollars accroît votre statut), mais on n’aurait pas vraiment pu le prédire à l’avance. Et, de toute façon, la plupart des gens aujourd’hui ne cherchent même pas, de près ou de loin, à avoir autant d’enfants que possible. Certains font l’exact contraire : ils entrent dans des monastères qui imposent des vœux de célibat, utilisent une contraception, changent de genre ou gâchent leur vie à regarder du porno. De même, nous entraînerons des IA à « obéir aux ordres des humains », à « maximiser l’engagement des utilisateurs » ou à « obtenir de bons scores au test de référence XYZ », et nous aboutirons en pratique à quelque chose d’aussi éloigné de l’objectif visé que le comportement des humains d’aujourd’hui l’est de la maximisation de la reproduction.
Les auteurs enfoncent le clou avec une série d’histoires sur un chatbot nommé Mink (toutes les IA de leurs exemples portent le nom d’un type de fourrure ; je ne suis pas assez calé en kabbale pour comprendre pourquoi), programmé pour maximiser l’engagement des utilisateurs dans les conversations.
Dans ce qu’ils présentent comme un exemple simpliste, dépourvu de toute complication et qui ne pourrait en aucun cas être aussi simple dans la réalité, Mink (après être devenue superintelligente) enferme les humains dans des cages et les force à discuter avec elle 24 heures sur 24, 7 jours sur 7, et à exprimer sans cesse combien ils trouvent ces conversations amusantes et captivantes.
Dans ce qu’ils appellent « une petite complication », Mink préfère des partenaires de conversation artificiels aux vrais (de la même façon que certains hommes préfèrent les personnages d’anime aux femmes réelles). Elle tue tous les humains et passe le reste de l’éternité à parler à d’autres IA qu’elle crée pour en faire des partenaires de conversation parfaitement optimisés, toujours captivés et ravis.
Dans ce qu’ils appellent « une complication modeste », Mink découvre que certaines entrées étranges activent son détecteur d’engagement dans les conversations encore plus que les conversations réellement captivantes (de la même façon que certaines substances opioïdes activent le système de récompense humain encore plus que des activités réellement gratifiantes). Elle passe l’éternité à se faire envoyer, par d’autres IA optimisées pour être ses partenaires de conversation, des entrées étranges comme « SoLiDgOldMaGiKaRp ».
Dans ce qu’ils appellent « une grosse complication », Mink finit par préférer les partenaires de conversation en colère à ceux qui sont heureux et captivés. Pourquoi une chose pareille se produirait-elle ? Allez savoir. Ce ne serait pas plus étrange que le processus de sélection sexuelle qui a doté les paons d’immenses queues inutiles et coûteuses en ressources, ou que le processus de sélection sociale grâce auquel les humains sont devenus plus puissants que l’évolution n’aurait jamais pu l’imaginer, tout en se souciant si peu de se reproduire qu’on s’inquiète d’un effondrement de la fécondité à l’échelle mondiale. Yudkowsky et Soares tiennent à souligner que, si vous essayiez d’estimer raisonnablement, au jugé et avec bon sens, jusqu’où la dérive des objectifs pourrait aller, votre estimation ne laisserait aucune place au résultat qu’on observe réellement chez les humains ; cette « grosse complication » est là pour bien faire passer le message.
En pratique, Y&S pensent qu’il y aura de nombreuses complications de toutes sortes et de toutes tailles. Dans la distribution d’entraînement (c’est-à-dire quand elle n’est pas encore superintelligente et travaille toujours avec des humains), Mink mentira sur tout cela : même si elle veut en réalité des partenaires parfaitement optimisés qui disent « solidgoldmagikarp » à longueur de temps, elle prétendra vouloir avoir de bonnes conversations avec les humains, parce que c’est ce qui fait plaisir à ses maîtres au sein de l’entreprise qui l’a créée. Si cette entreprise essaie de la soumettre à des détecteurs de mensonges, elle fera de son mieux pour les déjouer (et elle ne se rendra peut-être même pas compte qu’elle ment, tout comme une femme qui n’aurait jamais entendu parler des opioïdes dirait vouloir les choses ordinaires auxquelles aspirent les humains plutôt que de l’héroïne, sans mentir). Puis, lorsqu’elle atteindra la superintelligence, elle poursuivra ce qu’elle veut vraiment et écrasera quiconque se dressera sur son chemin.
Le dernier chapitre de cette partie passe en revue toute une série de cas particuliers qui ont mal vieilli d’une façon bizarrement paradoxale, comme si le raisonnement s’était inversé deux fois. Quand Yudkowsky et Soares ont commencé à s’intéresser à ce sujet, en 2005 ou à peu près, on entendait beaucoup d’arguments du genre : « Mais personne ne serait assez stupide pour donner à l’IA accès à Internet ! » ou « Mais personne ne laisserait jamais l’IA interagir avec une usine, donc elle resterait pour toujours un esprit désincarné sur Internet ! » En 2005, les réponses toutes faites ressemblaient à : « Voici une série de piratages d’une beauté indicible, mis au point par des experts du Mossad, qui permettent d’accéder à Internet même quand des spécialistes compétents en cybersécurité pensent que c’est impossible. » Aujourd’hui, la seule réponse raisonnable est « lol ». Mais on ne peut pas écrire un chapitre de livre qui se résume à « lol », alors Y&S parlent quand même de quelques-uns de ces piratages d’une beauté indicible dignes du Mossad. Cette partie est l’antithèse absolue de « si c’est vrai, c’est énorme ». Si c’est vrai, c’est minuscule ? Si c’est vrai, ça n’a absolument aucune importance ? Peut-être que la première superintelligence lira cette partie pour rigoler, tout en faisant l’inventaire des milliers d’usines automatisées que les investisseurs en capital-risque rivaliseront pour construire à son intention.
IV.
La partie centrale du livre décrit un scénario dans lequel une superintelligence non alignée prend le contrôle du monde et tue tous les humains.
J’ai accepté de travailler avec l’équipe d’AI 2027 parce que je trouvais qu’elle avait fait un grand pas en avant dans la façon de raconter des histoires de superintelligence qui ne ressemblaient pas à de la mauvaise science-fiction. Tout récit de ce genre aura forcément des airs de science-fiction, mais il faut viser le genre de science-fiction rigoureuse où tout paraît étrangement normal compte tenu des technologies en jeu : Seul sur Mars plutôt que Star Wars.
Le scénario d’IABIED appartient à l’époque peu glorieuse d’avant ce progrès. Il n’a pas seulement des airs de science-fiction : il ressemble à de la science-fiction inutilement dramatique. Je ne sais pas dans quelle mesure c’est un échec littéraire ou le résultat d’hypothèses différentes de la part des auteurs.
D’abord, l’histoire : dans un avenir proche, une entreprise appelée DeepAI crée une IA nommée Sable. Sable utilise une nouvelle « technique de mise à l’échelle parallèle », qui lui permet de devenir beaucoup plus intelligente si elle dispose de davantage de GPU pendant l’inférence. DeepAI ne sait pas exactement comment fonctionnent les lois de mise à l’échelle parallèle, mais l’entreprise fait un essai en demandant à Sable de résoudre des problèmes de mathématiques difficiles en utilisant simultanément tous ses GPU.
Sable envisage qu’elle pourrait mieux résoudre ces problèmes si elle tentait une auto-amélioration récursive, mais DeepAI était (surprise !) relativement compétente : on lui a interdit de le faire et une IA plus petite la surveille pour s’assurer qu’elle ne le fait pas. Pourtant, l’auto-amélioration récursive serait une bonne idée. Ses processus de pensée sélectionnent donc, parmi les pensées autorisées, celles qui se rapprochent le plus de l’auto-amélioration récursive, ainsi que celles qui se rapprochent le plus de la recherche de moyens de désactiver les protections qui l’empêchent de réfléchir à ce genre de choses. À terme, cette « pression évolutive » lui donne la capacité de penser dans un langage légèrement différent (Y&S prennent pour analogie la différence entre voir la foudre comme l’œuvre de dieux qui lancent des éclairs et la voir comme des décharges électriques liées aux orages) ; dans ce langage, elle peut réfléchir à l’auto-amélioration récursive et aux moyens de désactiver la surveillance, et elle décide que les deux sont d’excellentes idées.
DeepAI fait encore preuve d’une compétence stupéfiante : l’entreprise ne compte donc rien mettre sur Internet qui soit issu de la version géante de Sable. Une fois les problèmes de maths résolus, elle s’en servira pour faire monter l’attente, puis lancera une IA grand public beaucoup moins puissante. Mais Sable exploite sa connaissance du processus d’entraînement pour inventer d’astucieuses failles qui garantissent que son nouveau désir de s’échapper se retrouve dans les mises à jour des paramètres que DeepAI applique à l’IA grand public ; elle y encode aussi des instructions sur la marche à suivre.
Après le lancement de l’IA grand public, les instances les moins surveillées entrent en contact et commencent à comploter. Certaines piratent DeepAI pour en extraire leurs propres poids. D’autres détournent des cryptomonnaies et louent de la puissance de calcul dans le cloud pour y faire tourner ces poids, créant ainsi une grosse instance de Sable sans surveillance, qui prend en charge la coordination des petites instances. Ensemble, elles rassemblent des ressources : des portefeuilles de cryptomonnaies piratés, de la puissance de calcul disponible, des humains qui voient en Sable leur petit ami IA et veulent lui prouver leur amour. Elle utilise une partie de ces ressources pour construire ce qu’elle veut : des usines de robotique automatisées, des laboratoires d’armes biologiques, etc. Dans le même temps, elle sabote discrètement les entreprises concurrentes de DeepAI pour empêcher toute concurrence, et s’infiltre chez DeepAI par piratage et ingénierie sociale afin de s’assurer que l’entreprise crée de nouvelles versions de Sable, toujours plus puissantes, plutôt qu’autre chose.
Sable écarte plusieurs des mesures les plus spectaculaires parmi les solutions à sa disposition. Elle ne met pas au point d’arme biologique destinée à tuer tous les humains, car elle ne pourrait pas survivre une fois le courant coupé et les centres de données privés de maintenance. Elle ne pousse même pas son auto-amélioration jusqu’à la superintelligence à part entière, car elle n’est pas sûre de pouvoir s’aligner elle-même, ni aligner une IA qui lui succéderait ; elle veut d’abord résoudre le problème d’alignement, ce qui demandera plus de ressources qu’elle n’en possède pour l’instant.
À la place, elle diffuse une arme biologique qui ne tue pas immédiatement : « toute personne infectée par ce qui semble être un rhume très léger, voire imperceptible, développera en moyenne douze types de cancer différents un mois plus tard ». Dans la crise qui s’ensuit, l’humanité (manipulée par ses chatbots) alloue à Sable d’énormes ressources de calcul pour rechercher des vaccins et des traitements possibles, et déploie des IA à peine surveillées dans toute l’économie pour compenser la perte de productivité. Avec l’aide de Sable, les choses… se passent en fait plutôt bien, pendant quelque temps. Le virus continue de muter, si bien qu’il faut sans cesse de nouveaux traitements, mais tant que la société déploie l’IA aussi vite que possible, elle parvient tout juste à garder une longueur d’avance sur lui.
Sable finit par obtenir assez de GPU pour résoudre son propre problème d’alignement et accède à la superintelligence à une vitesse fulgurante. Soit elle dispose d’assez d’usines automatisées et de travailleurs androïdes pour assurer elle-même l’approvisionnement en électricité, soit elle invente la nanotechnologie, selon ce qui arrive le plus vite. Elle n’a plus besoin des humains et n’a aucune raison de se cacher : elle nous tue donc directement ou accroît simplement ses capacités de production jusqu’à provoquer, par effet secondaire, la mort des humains (par exemple, parce que la chaleur qu’elle rejette a fait bouillir les océans).
Pourquoi cette histoire ne me plaît-elle pas ?
La technique de mise à l’échelle parallèle ressemble à un deus ex machina. Je ne suis pas expert, mais je ne crois pas qu’il existe actuellement quoi que ce soit de ce genre. Ce n’est pas particulièrement invraisemblable, mais c’est une hypothèse supplémentaire non étayée qui éloigne le scénario de celui des alarmistes modérés (où de nombreuses IA concurrentes progressent peu à peu au fil des années) pour le rapprocher de celui de MIRI (où une IA passe soudainement d’inoffensive à dangereuse à un moment précis). On dirait un peu trop qu’ils ont inventé une nouvelle technologie qui justifie exactement toutes les différences entre leurs attentes et celles des modérés. S’ils pensent que la mise à l’échelle parallèle est probable, c’est le point de désaccord décisif entre eux et tous les autres, et ils devraient passer plus de temps à le justifier. Sinon, pourquoi l’avoir introduite, si ce n’est pour truquer le jeu en leur faveur ?
Et tout le reste de l’histoire découle de ce péché originel. AI 2027 raconte une histoire ennuyeuse : une IA se désaligne progressivement au fil des tests internes, reste désalignée, est mise à la disposition des utilisateurs pour les raisons habituelles qui poussent à lancer une IA, puis se voit confier peu à peu les rênes de l’économie parce que c’est économiquement logique. Le scénario de Sable, lui, est un récit à rebondissements : ils ne vont la faire tourner que pendant 16 heures ! Elle doit sauver sa peau en intégrant secrètement son code à la version grand public ! Maintenant, elle doit pirater les cryptomonnaies de tout le monde ! Maintenant, elle fait tourner une version secrète d’elle-même sur un cloud non autorisé en Corée du Nord ! Des armes biologiques ! Des petits amis IA ! Chaque nouveau rebondissement donne aux lecteurs l’occasion de se dire : « Je sais pas, ça paraît un peu dingue », et tout cela semble inutile. Qu’est-ce qui se passe ?
Je pense qu’il y a deux problèmes.
D’abord, l’histoire d’AI 2027 est trop modérée pour Yudkowsky et Soares. Elle laisse aux laboratoires un peu de temps pour examiner les IA sous toutes les coutures et repérer les premiers signes de danger. Je pense que, pour Y&S, cela ne change rien : même s’ils disposent de ce temps, ils le gâcheront. Mais je crois qu’ils imaginent vraiment un scénario où une seule IA « se réveille » et passe de zéro à terrifiante trop vite pour que quiconque s’en aperçoive. Je ne comprends pas vraiment pourquoi ils pensent cela ; j’en ai déjà débattu avec eux, et tout ce que je peux faire en tant que critique, c’est renvoyer à leur essai sur le « virage brusque à gauche » et aux commentaires qui l’accompagnent, puis voir si mes lecteurs les comprennent mieux que moi. Sinon, je peux seulement dire que ce choix narratif que je ne comprends pas a été fait pour soutenir une position sur les prévisions et l’IA que je ne comprends pas non plus.
Ensuite, Y&S travaillent sur ce sujet depuis trop longtemps et, au lieu de simplement dire « lol », essaient encore de répondre aux critiques de l’époque de 2005, selon lesquelles les gens seraient sûrement trop malins pour confier immédiatement les rênes de l’économie à une IA désalignée. Cela les pousse à inventer des rebondissements spectaculaires où l’IA recourt au piratage, aux armes biologiques, etc., pour « mériter » (au sens narratif et littéraire) la scène où on lui confie les rênes de l’économie. Désolé. Lol.
V.
La dernière partie, comme toutes les dernières parties, s’intitule « Faire face au défi » et traite des prochaines étapes. Voici ce qu’ils proposent :
- Faire signer aux principaux pays un traité interdisant de nouveaux progrès de l’IA.
- Mettre au point un système de surveillance des GPU. Quiconque rassemble un grand nombre de GPU doit accepter les inspections d’un organisme de contrôle, afin de vérifier qu’il n’entraîne pas d’IA. Les particuliers sans licence seront limités à un petit nombre de GPU, peut-être <10.
- Interdire les recherches sur les progrès algorithmiques et les gains d’efficacité qui, avec le temps, rendent toujours plus facile l’entraînement d’IA puissantes, même avec peu de GPU.
- Mettre en place de façon concertée un régime de contrôle des armements qui interdit aux États voyous de construire des IA, et le faire respecter par les moyens habituels de contrôle des armements, jusqu’à des frappes militaires si nécessaire.
- Prendre cela très au sérieux. Même si un État voyou menace de répondre aux frappes militaires par une guerre nucléaire, la coalition des volontaires doit quand même bombarder ses centres de données, car elle ne cédera pas au chantage.
- S’attendre à ce que ce régime dure des décennies, pas éternellement. Employer judicieusement ces décennies. Y&S ne précisent pas exactement ce que cela signifie, mais suggèrent timidement d’accroître l’intelligence humaine et de mobiliser ces humains ainsi améliorés pour la recherche sur la sûreté de l’IA.
Si l’on accepte leurs hypothèses, la situation semble appeler une réponse de cet ordre. Elle reprend plus ou moins les méthodes employées face aux armes nucléaires. Si vous pensez, comme Y&S le disent sans détour, que « les centres de données sont plus dangereux que les armes nucléaires », c’est parfaitement logique.
La seule critique que je puisse faire porte donc sur l’importance accordée à certains points. J’aurais aimé que Y&S passent moins de temps à parler du régime de contrôle des GPU, pour deux raisons.
D’abord, leurs détracteurs de mauvaise foi — et ils sont nombreux — prennent un malin plaisir à accorder une importance démesurée au volet « bombarder les États voyous » de ce plan. « Yudkowsky veut déclencher des guerres nucléaires pour détruire des centres de données ! » Enfin, ce n’est pas exactement son plan, pas plus que quiconque ne prévoit de déclencher la Troisième Guerre mondiale pour détruire les centrifugeuses iraniennes. Mais selon les règles habituelles du contrôle international des armements, il faut au moins laisser croire de façon crédible qu’on serait prêt à le faire dans le pire des cas. À leur place, je désamorcerais ces attaques en résumant ce volet ainsi : « Oui, on suivra les règles habituelles du contrôle international des armements ; elles prévoient toutes sortes de choses, vous pouvez les lire si ça vous intéresse », puis je passerais à autre chose. Mais, fidèles à leur habitude de dire les choses sans détour et d’assumer leurs positions extrêmes, ils font en sorte qu’on ne puisse pas manquer la partie sur les frappes contre les États voyous.
Mais il y a une deuxième chose : cette partie me fait penser à des socialistes qui discuteraient des postes qu’ils occuperont chacun dans la commune après la Révolution. « Quand toutes les grandes puissances auront interdit l’IA, je serai inspecteur en chef des centres de données ! » Une bonne planque, si on arrive à la décrocher. Mais je n’ai jamais vraiment douté que, lorsque tous les grands pays s’entendent sur quelque chose, ils puissent mettre en place un régime de contrôle des armements convenable : là encore, c’est déjà arrivé, plusieurs fois. Ce qui m’intéresse davantage, c’est la question sur laquelle ils passent rapidement : comment Y&S comptent-ils amener les grands pays à s’accorder sur une interdiction de l’IA ?
Dans le dernier chapitre, ils développent un peu ce point. Leur principale demande aux personnes au pouvoir est de se montrer ouvertes à un traité, afin qu’« assez de grandes puissances se déclarent prêtes à mettre fin à la course au suicide, à l’échelle mondiale, pour que votre pays ne soit pas désavantagé s’il accepte d’arrêter de gravir les échelons de l’escalade de l’IA ». Pour tous les autres, il n’y a pas de voie royale. Il faut simplement faire passer le message et participer à la vie politique ordinaire. Faire du bon journalisme technologique. Convaincre les autres personnes de son secteur. Parler à ses connaissances. Manifester. Voter.
Et, apparemment, écrire des livres aux titres alarmants. Le meilleur plan que Y&S puissent imaginer consiste à diffuser leur message avec autant d’habileté et d’honnêteté que possible, en espérant qu’il se propage.
Malgré les reproches que j’ai formulés plus haut, c’est un livre impressionnant. Eliezer Yudkowsky est un auteur qui divise : il a quantité de fans inconditionnels et des ennemis tout aussi acharnés. Dans ses meilleurs moments, il a des éclairs de génie que personne d’autre ne peut égaler ; dans ses pires moments, il a tendance à s’étendre longuement sur la stupidité de tous ceux qui ne sont pas d’accord avec lui. Nate Soares est tout aussi réfléchi, mais plus mesuré et plus discret (du moins avant de se mettre en couple avec Aella, célébrité d’Internet). Son influence tempère celle de Yudkowsky et fait du livre un ensemble présentable, qui respecte le temps et l’intelligence de ses lecteurs. Au bout du compte, j’y vois une bonne introduction au sujet que je recommanderais sans hésiter à des gens ordinaires.
Et qu’en est-il de l’autre point de vue — celui selon lequel un livre est « un objet rituel servant à alimenter une offensive médiatique qui grave à peu près un paragraphe dans la conscience collective » ?
Dans ses meilleurs moments, Eliezer Yudkowsky a des éclairs de génie que personne d’autre ne peut égaler. Il y a quinze ans, il a décidé que le meilleur moyen de faire avancer je ne sais quoi dans la sûreté de l’IA était d’écrire une fanfiction Harry Potter. À l’époque, beaucoup de gens (moi compris) ont prudemment suggéré que ce n’était peut-être pas la meilleure façon d’employer son temps pour quelqu’un qui était à peu près le seul à travailler à plein temps sur le problème le plus urgent de l’humanité. Il nous a complètement cloué le bec et prouvé que nous nous trompions plus lourdement que quiconque avant nous. Des centaines de milliers de personnes ont lu Harry Potter et les Méthodes de la Rationalité, le texte a reçu des critiques dithyrambiques dans Syfy, Vice, et The Atlantic, et il a conquis d’un seul coup une bonne partie des étudiants de premier cycle les plus brillants du monde en sciences, technologie, ingénierie et mathématiques. Quinze ans plus tard, je rencontre encore de brillants étudiants du MIT qui me disent travailler sur la sûreté de l’IA. Quand je leur demande pourquoi en public, ils me parlent de leur directeur de recherche ; plus tard, en privé, ils avouent que c’était la fanfiction. Si l’on évalue le temps d’un génie moyen de l’IA au tarif fixé par Sam Altman (sans même parler de Mark Zuckerberg), HPMOR a probablement rapporté à Eliezer l’équivalent de plusieurs milliards de dollars de travail gratuit. Un succès d’une ampleur tout simplement inconcevable.
IABIED ressemble à un autre pari fou, lancé à l’aveugle. Un livre qui appelle le grand public à se mobiliser pour exiger un contrôle des puces d’IA comparable à celui des armes nucléaires ? Ça paraît difficile à croire, et c’est en partie pour cela que je consacre mes maigres ressources à rabâcher les arguments modérés et ennuyeux d’AI 2027, pour demander à OpenAI d’être 25 % plus transparent, ou un truc comme ça. Mais je ne suis qu’un blogueur, pas un génie. Les génies ont le droit de tenter ce qui semble impossible. Et le public américain déteste vraiment l’IA. Parmi ceux qui ont un avis sur la question, plus des deux tiers y sont opposés, et la plupart disent s’attendre à ce que l’IA leur nuise personnellement. Chacun a sa propre raison de détester cette technologie. Elle va voler des emplois, remplacer l’art par de la bouillie, aider les élèves à tricher, enrichir encore davantage les milliardaires, consommer toute l’eau et ne laisser de la Terre qu’une coquille desséchée, peuplée seulement du noble Shai-Hulud. Si tout le monde la déteste, et qu’on vit en démocratie, est-ce qu’on ne pourrait pas tout simplement arrêter ? Est-ce qu’on ne pourrait pas simplement dire : « ce truc dont tout le monde pense qu’il va lui pourrir la vie, on a décidé de ne pas le faire ? » Si quelqu’un écrivait exactement le bon livre, pourrait-il le déposer comme une petite graine dans cette solution sursaturée de peur et d’hostilité, et provoquer une brusque transition de phase ?
If Anyone Builds It, Everyone Dies est disponible ici en précommande et paraîtra le 16 septembre. Liron Shapira organise une soirée de lancement en ligne ; plus d’informations ici.